Что ты получишь, прочитав эту статью
- почему лимиты кончаются быстрее, чем кажется, и куда они уходят
- что делает Graphify и чем это отличается от векторного поиска
- команду установки, проверенную по PyPI
- честный разбор цифры «в 71,5 раза меньше токенов»
- чего он не умеет
Знакомое ощущение: работаешь полчаса, а лимиты уже на исходе. Причём код почти не писался.
Объяснение простое. Агент не помнит ваш проект между сессиями. Каждый новый разговор он начинает с чтения: открывает файлы, ищет, где что определено, прослеживает связи. На средней кодовой базе это десятки тысяч токенов до того, как он приступит к вашей задаче.
Что делает Graphify
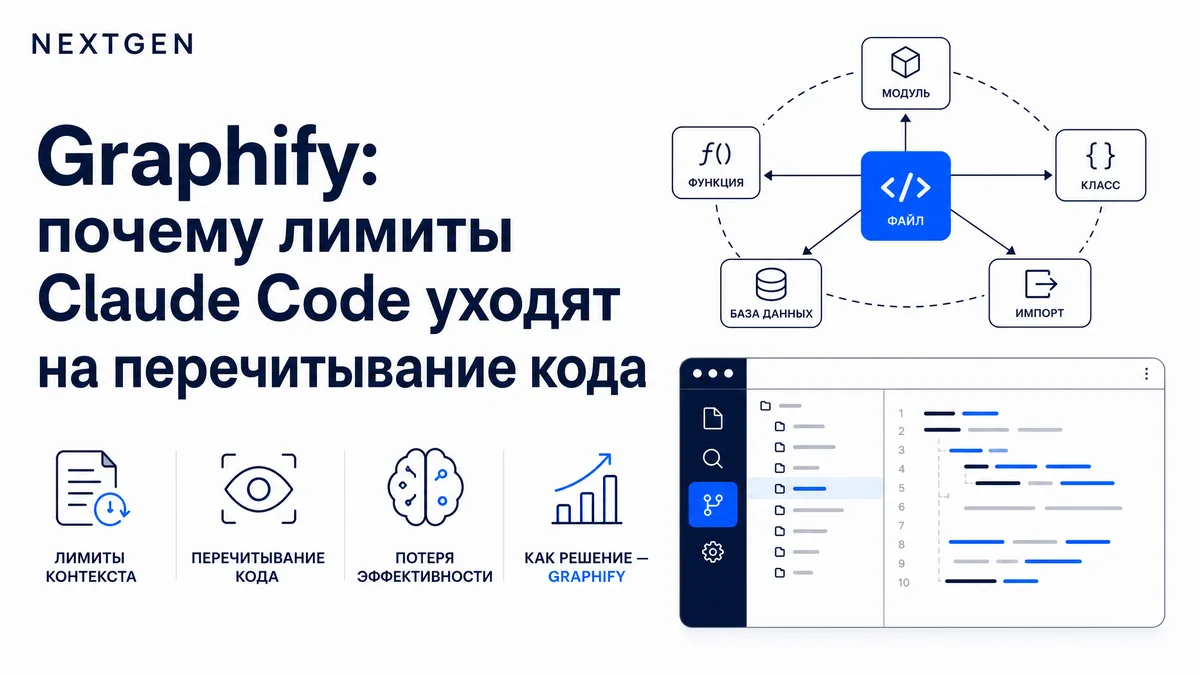
Один локальный прогон разбирает проект и строит граф связей: что откуда вызывается, где определено, что на что ссылается.
Дальше агент не читает файлы подряд. Он спрашивает граф: «где определена эта функция», «кто её вызывает», «что сломается, если её поменять». Получает точный ответ вместо того, чтобы прочитать полпроекта ради одного факта.
Заметка
Это не векторный поиск. Вектора ищут похожее по смыслу и могут ошибаться. Граф хранит фактические связи кода, и ответ на «кто вызывает эту функцию» там точный, а не вероятностный.
| Что | Значение | Проверено |
|---|---|---|
| Репозиторий | Graphify-Labs/graphify | GitHub API, 22.09.2026 |
| Звёзд | 120 335 | там же |
| Форков | 11 618 | там же |
| Лицензия | Apache-2.0 | там же |
| Создан | 3 апреля 2026 | там же |
| Пакет PyPI | graphifyy, версия 0.9.65 | pypi.org |
Установка
pip install graphifyy && graphify installРаботает локально: ни серверов, ни облачных векторных баз, код наружу не уходит. Для коммерческой разработки и клиентских проектов это принципиально.
Разбирает не только код: подхватывает документацию, схемы БД, конфиги и PDF. То есть в граф попадает и то, что обычно лежит рядом с проектом и всегда читается заново.
Честно про «в 71,5 раза меньше токенов»
Эту цифру называют авторы. Она получена на их собственном наборе из 52 файлов при сравнении запроса к графу с чтением сырых файлов.
Главное
Я эту цифру не перепроверял и за свою не выдаю. Относиться к ней стоит как к верхней границе на удобном для авторов примере, а не как к тому, что вы получите на своём проекте.
Но даже доля такого эффекта на длинной сессии видна сразу: сессия живёт дольше, и лимит кончается на работе, а не на разогреве.
Это общая закономерность, про которую я писал и раньше: выигрыш инструмента почти всегда меряют на примере, где он выигрывает сильнее всего.
Чего ждать не стоит
- Граф надо обновлять. Код поменялся, граф устарел. Прогон дешёвый, но про
него надо помнить.
- Он не делает агента умнее. Он делает его осведомлённее дешевле. Плохо
сформулированная задача останется плохо сформулированной.
- На крошечном проекте выигрыша почти нет. Если у вас три файла, агент
прочитает их и так.
- Первый прогон занимает время, пропорционально размеру базы.
Способ быстрее: отдай эту статью своему Claude
Вот статья: https://nextgenclub.ru/blog/graphify-graf-vmesto-perechityvaniya
Прочитай её, поставь Graphify по инструкции в отдельную копию моего проекта
и построй граф. Потом покажи, сколько файлов он разобрал и что попало
в граф кроме кода.
Частые вопросы
Это платно?
Данные уходят наружу?
Работает только с Claude Code?
Заменяет ли это файл памяти проекта?
Насколько реально экономит?
Больше про Claude и AI-инструменты в работе - в моём Telegram-канале Виктор Дачников | NEXTGEN.
Лёгкий старт
Разбираю инструменты с границами применимости
Забери бесплатный пошаговый план «Лёгкий старт в Claude Code» прямо в Telegram: доступ, первые шаги и маршрут под тебя.
Получить план в боте